

DGX Spark上手玩:能做AI服务器?还能玩《赛博朋克2077》?
来源:电子工程专辑
发布时间:2026-02-02
如我们这般的非软件或AI应用工程师,对NVIDIA DGX Spark这款设备的最初印象就是“核弹”:尤其老黄最初在发布这台能托在手里的桌面设备时,提到它的性能堪比当年送给OpenAI、120斤重、13万美金的DGX-1,以及FP4算力1 PetaFLOPS的时候,我们多少还是怀着仰望的目光的。
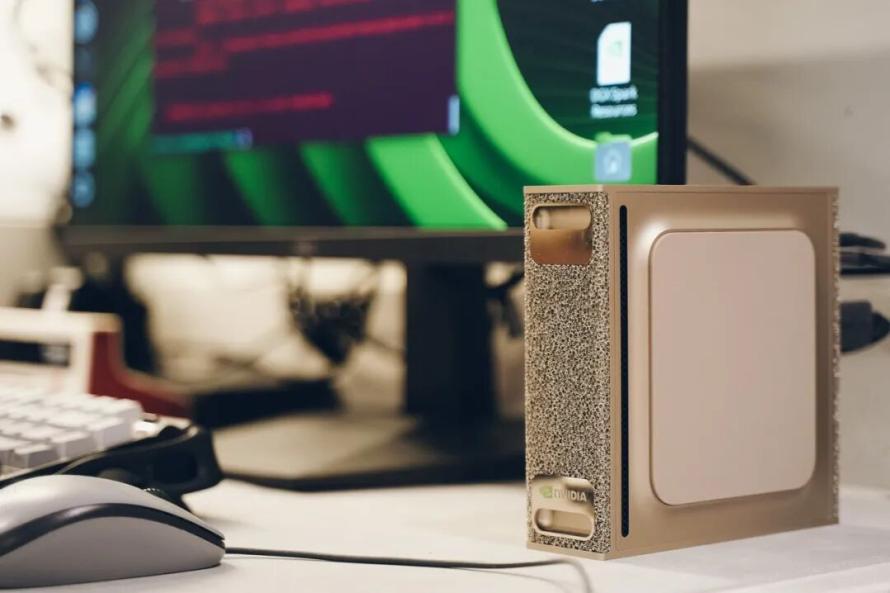
不过当亲自上手DGX Spark,首先感觉到的是它本质上与去年上手的Jetson Orin Nano很像:相似的环境、相似的硬件,只不过DGX Spark规模更大——应了老黄说的一个架构覆盖各市场。随着体验的深入,我们开始逐步了解DGX Spark能做什么,则基于DGX Spark的算力及其“深度学习计算机”的定位,这绝对是激发AI巨大热情的设备。这样的认知转变在体验过程中显得非常有趣。
虽说受限于时间,无法很全面地体验和深入DGX Spark的各方各面,但仍旧期望借助这篇文章和后续将在电子工程专辑微信视频号发布的视频,来谈谈这几天使用DGX Spark的感受:不夸张地说,它开启了我们未来进一步学习AI技术的大门,是以往的任何个人端侧设备都不能做到的——怪不得NVIDIA设定DGX Spark的目标用户群也包括有AI专业学生。
我们认为,即便你没学过AI,但只要有一定的计算机科学基础,DGX Spark就能以倍速带你入门。
Aarch64 + Linux小电脑好玩吗?
先谈谈DGX Spark的软硬件概况,以便各位同学对它有更明确的预期。硬件的基本配置就不多谈了,电子过程专辑的历史文章谈得够详细了。简单来说,其核心部分是20核Grace CPU以及Blackwell GPU。虽然NVIDIA称其为GB10 Superchip,名字里沾了Grace,命名方面与GB200很像;
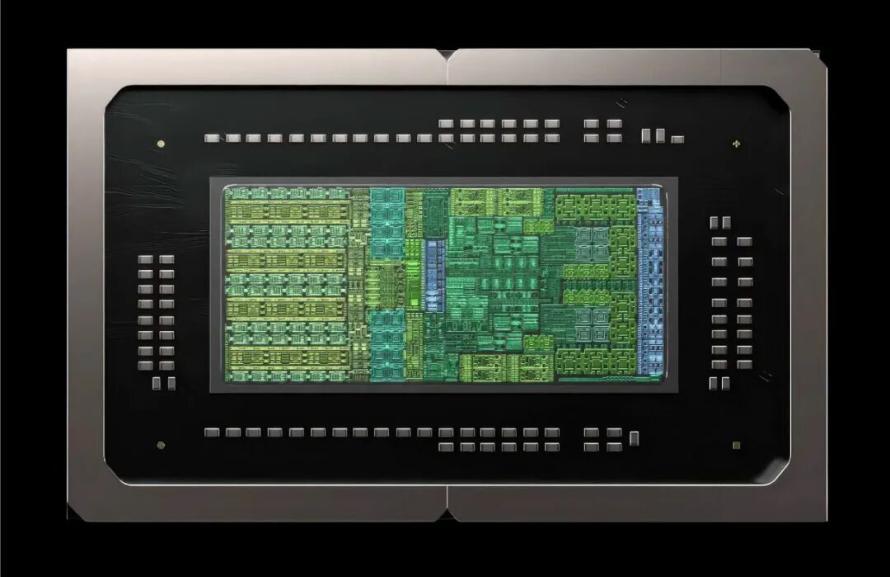
GB10芯片,与数据中心Grace Blackwell芯片不同,这是一颗monolithic的SoC,CPU和GPU在同一片die上,没有基于chiplet
但一方面此Grace非彼Grace,相比于数据中心那个主要基于Neoverse V2的Grace,这颗Grace是10x Cortex-X925 + 10x Cortex-A725,总共20个核心——只不过需要明确,抛开cache和NOC等扩展部分不谈,Neoverse V2与Cortex-X3算得上近亲,而Cortex-X925是比前两位都更先进的核心IP...
此外,硬件部分让DGX Spark有些不大像消费电子或个人产品的一部分是其中的ConnectX-7 NIC,基于NCCL支持RDMA和GPUDirect。两台级联达成最高400Gbps的传输速率。这东西以前还只在探讨数据中心的scale-out时才会聊起,相比PC行业被认为很快很快的Thunderbot都是妥妥的降维打击。
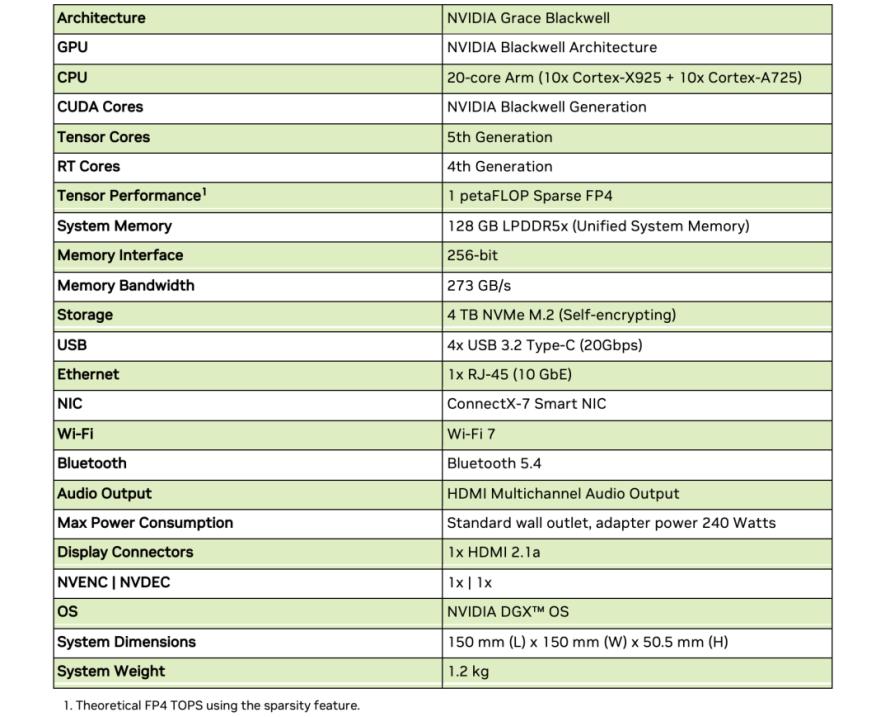
NVIDIA的GB10官方配置表;去年Computex台北电脑展期间,有关GB10更明确的规格,外媒还给到了一些传言信息,此处列出供各位参考:Blackwell GPU部分具体为6144 CUDA core,192 TMU, 32 ROP, 192 Tensor core,48 RT core,24MB L2共享缓存...;另从lscpu在设备上查询到的信息来看,Cortex-X925最高频率4004MHz,Cortex-A725最高频率2860MHz——但注意,以上信息未必可靠...
硬件层面,除了让人颇感惊叹的ConnectX-7 NIC之外,其实也没有必要神化这款桌面设备。一方面是20核CPU的PC处理器如今不算罕见——数据中心服务器的那些家伙动辄64核128线程,而且核心同为面向消费级市场的Cortex IP;另一方面,DGX Spark自带的电源适配器也就240W,这就给到了物理层面明确的性能天花板——要知道仅是NVIDIA自家的GeForce RTX 5080 FE显卡TGP就360W。
从这个角度来看,DGX Spark仍是一款端侧或边缘产品,也是我们在上手DGX Spark之前将其视作AI PC的原因——即便NVIDIA官方称其为“桌面上的Blackwell AI超级计算机”。只不过这台“AI PC”一方面是基于Arm指令集,另一方面所用操作系统DGX OS是NVIDIA融入了自家AI全栈生态、深度定制过的Ubuntu。若一定要放在PC领域内,这当然是罕见的。
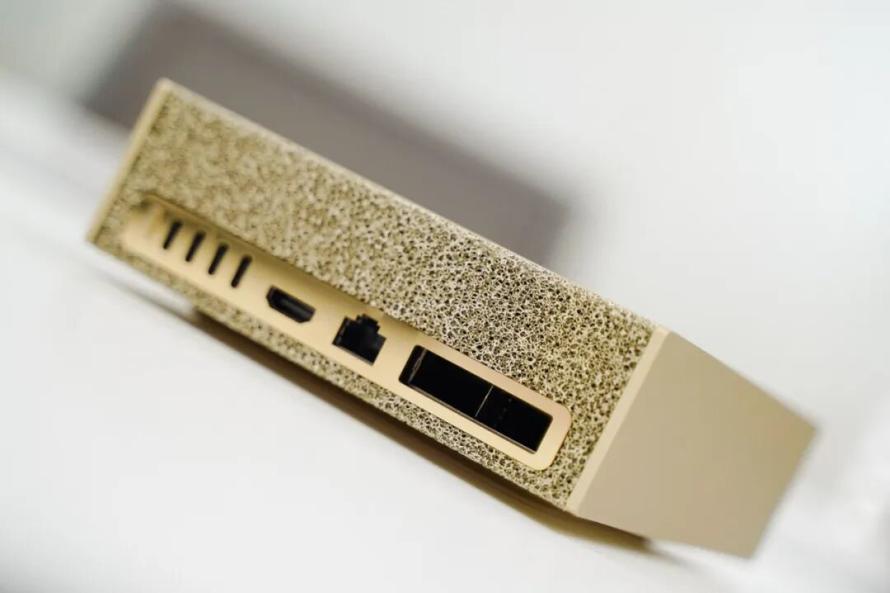
Phoronix Test Suite读取到的硬件型号资料——主板: NVIDIA P4242, BIOS Version: 5.36_0ACUM018, 网络: 4x Mellanox MT2910 + Realtek Device 8127 + MEDIATEK Device 7925; SSD: 4097GB Samsung MZALC4T0HBL1-00B07 + 2 x 0GB H31 (file system: ext4)
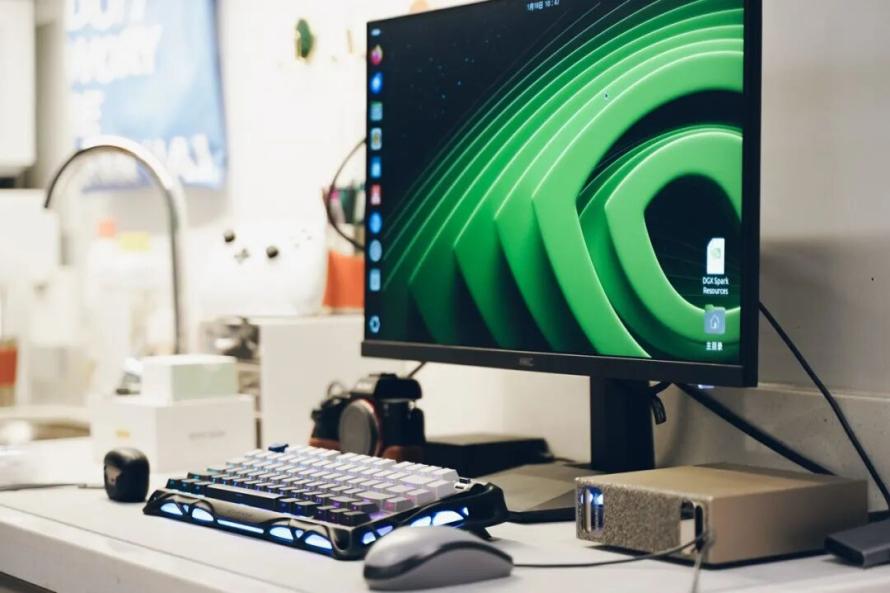
软件环境方面,OS: Ubuntu 24.04, Kernel: 6.14.0-1015-NVIDIA (aarch64), Desktop: GNOME Shell 46.0, Display Server: X Server 1.21.1.11, Compiler: GCC 13.3.0 + CUDA 13.0, OpenGL: 4.6.0, OpenCL 3.0 CUDA 13.0.94...
如果真拿DGX Spark当PC来用,就要面临PC需求的各种不便——哪怕x86 + Linux或Aarch64 + Windows都算得上有些属于PC生态的积累;而Aarch64 + Linux在传统的个人生产力、娱乐方面就有些一言难尽了。如果你拿它当主要由CPU驱动的传统HPC工作站来用,其实也因为软件生态的关系而有些捉襟见肘。
但面对DGX Spark时,需要明确一个基本事实:NVIDIA家族的数据中心和边缘产品都是这套生态,比如Jetson、DRIVE。当Aarch64 + Linux + NVIDIA,AI与数字孪生相关的生态优势,此刻就产生了强大的生态粘性;是DGX Spark相较硬件规格上的同级产品真正的闪光点所在,也是任何其他生态在该领域内都难以比拟的。
戏说DGX Spark通用算力水平,和能不能玩游戏
在开谈DGX Spark的AI本职工作之前,如果还是用PC或传统工作站的思路来对待DGX Spark,那么跑分就是基操——包括很多人关心的DGX Spark作为绿厂的核弹级产品,能不能玩游戏的问题。
按照电子工程专辑平常体验个人端侧产品的惯例,先了解功耗有助于做性能预期:Aarch64 + Linux平台的系统资源监测工具不少,但在DGX Spark生效的不多;尝试用nvidia-smi观察不同负载下的功耗数据——似乎因为系统层面不提供详实的功耗数据,所以nvidia-smi也仅能看到“GPU Power Reading”这一项的值(不包含内存/显存)。故而在3个重载场景下(GPU资源占用率均在90%以上)简单记录了该读数,可作为性能预期的参考:
(1)GPT-OSS 120B模型推理时,GPU Power峰值不到45W;
(2)对FLUX.1-dev 12B模型进行LoRA fine-tune时,峰值功耗约85W;
(3)FurMark甜甜圈图形压力测试时,GPU Power峰值在90+W,10分钟压力测试GPU温度最高80℃。
CPU的功耗数据虽然未知,但我们费劲吃奶的力在Aarch64 + Linux生态下build出了一些总算能看、且虽然不多但大概有参考价值的benchmark基准测试(所以标题是“戏说性能水平”)。原本想自己写一些脚本来跑microbenchmark,但一方面是时间受限,另一方面是手头没有其他适合对比的设备,就算跑了也没有对照基准和参考意义——所以只能尽可能找一些现成的系统级测试来跑。
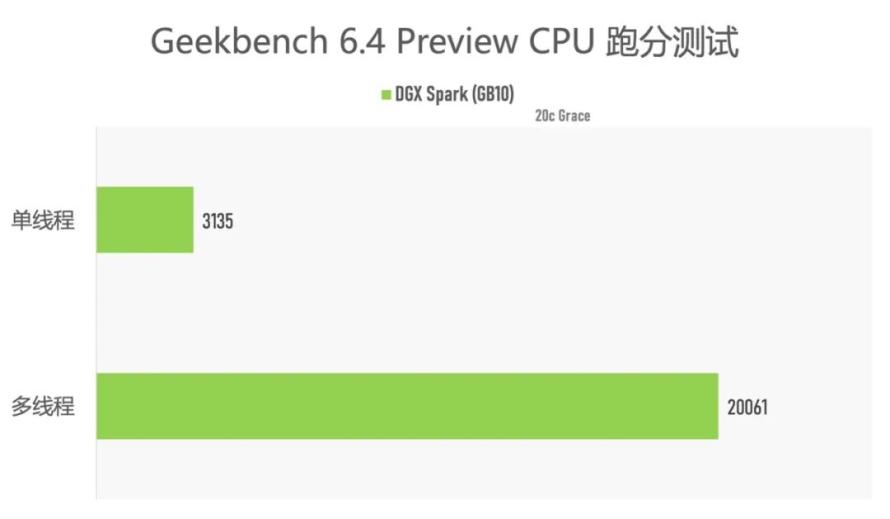
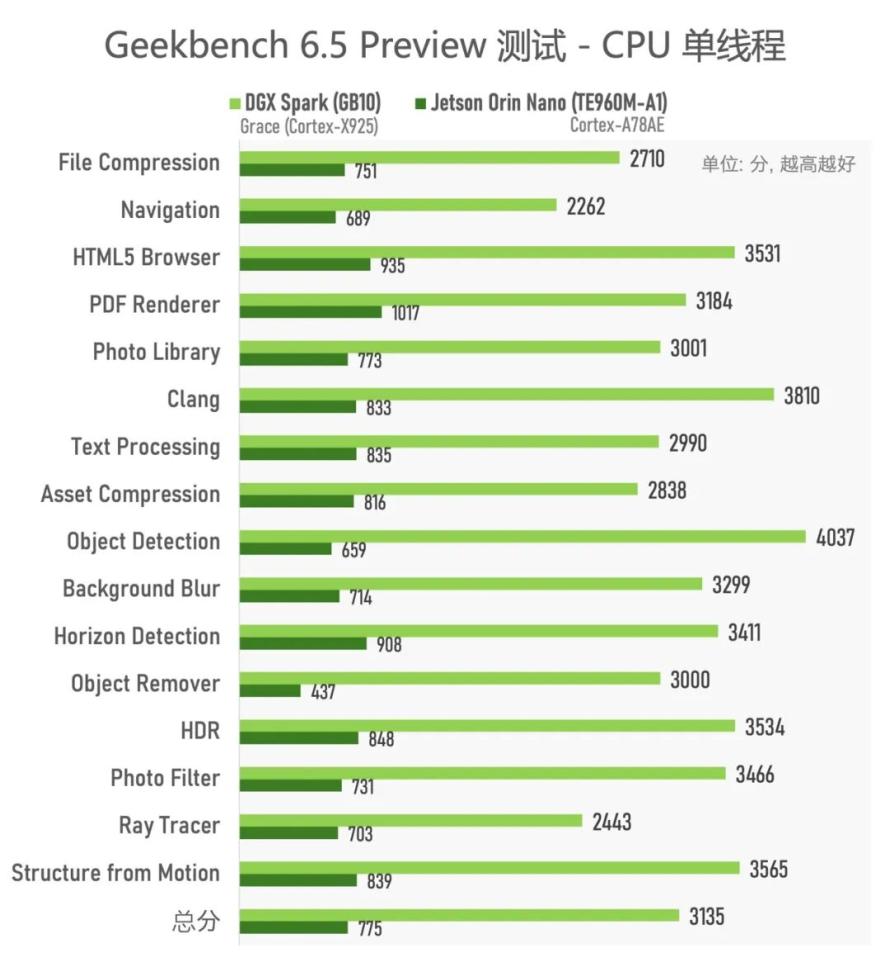
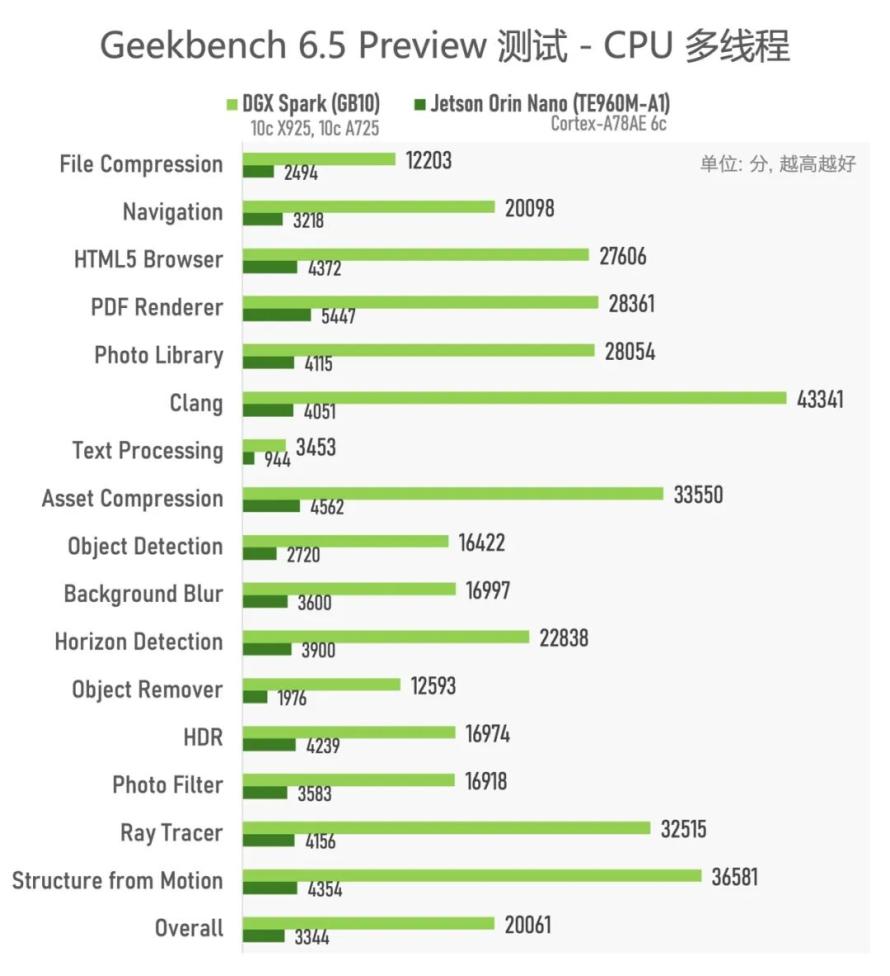
首先是平易近人、在PC界很受欢迎的Geekbench——虽然面向Aarch64 + Linux时,它也只是个Preview预览版,即仅供参考。不确定这个成绩是否能与PC或移动平台的其他设备直接横向对比(大概率不能,如果lscpu给到Cortex-X925 4GHz的最高频率可信,则这些值在更通用的非预览版测试中是明显偏低的);手头能参考的,也只有同平台同架构的Jetson Orin Nano了(虽然的确也没啥意义)。
跨不同平台尤其还涉及到跨基础指令集架构差异时,任何高抽象层级的测试,尤其在Aarch64 + Linux这种于PC领域相对冷门的平台,考验的更大程度还是软件——所以,很多跨平台测试大概率很难反映或对比硬件的实际性能水平。
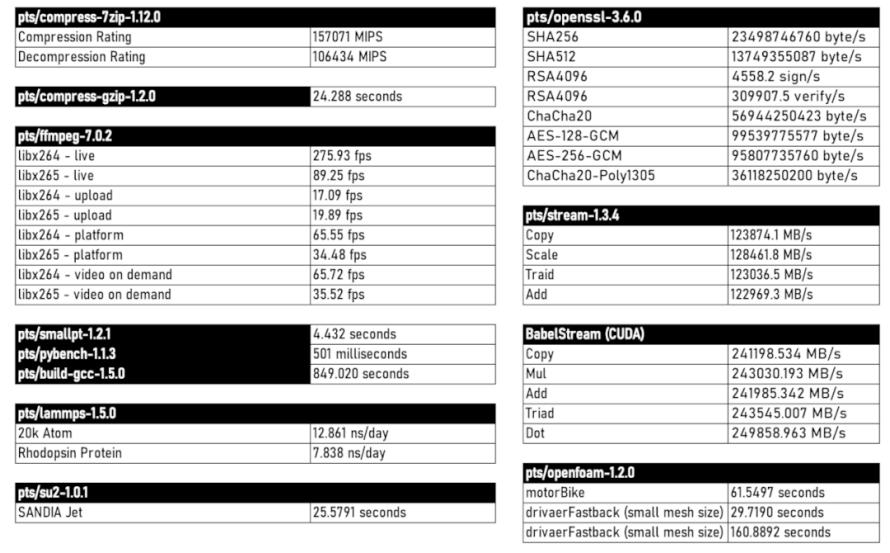
另外就CPU性能,这里还跑了Phoronix Test Suite测试套件中的压缩(7zip, Gzip)、媒体编解码(ffmpeg)、光追(smallpt,浮点管线压力测试)、编译(gcc)、AI工作流相关的Python性能测试(pybench)、内存带宽(stream, BabelStream-该系列测试中唯一GPU加速的),以及一些HPC测试(openfoam & su2 - 仅CPU参与的计算流体力学;lammps - 分子动力学模拟),如上图所示。
OpenBenchmarking社区有这些测试的可参照对象,感兴趣的同学可以将这组数据与社区中其他CPU的数据做对照,这里就不列出了。单纯从硬件层面来看,要干PC的事儿,DGX Spark自然没什么压力;但要干传统HPC、科学计算的活儿,也是有些为难它了。
至于DGX Spark的GPU图形性能,以及能不能跑游戏的问题,考虑其整机功耗限制,及上述测得的GPU功耗数据,加上x86 + Windows系统跑游戏时完全不同的软件栈构成,DGX Spark的图形和游戏性能大概率很难与GeForce RTX高端卡相比,毕竟人家的主职不是图形渲染。
不过针对图形渲染我们也做了测试。比较有趣的是DGX Spark竟然能build并顺利跑起FurMark甜甜圈测试(PC显卡用户狂喜)。至少这个值能相对有效地给到“如果跑游戏DGX Spark能跑到何种程度”的量级概念,虽然它可能也不够准确。
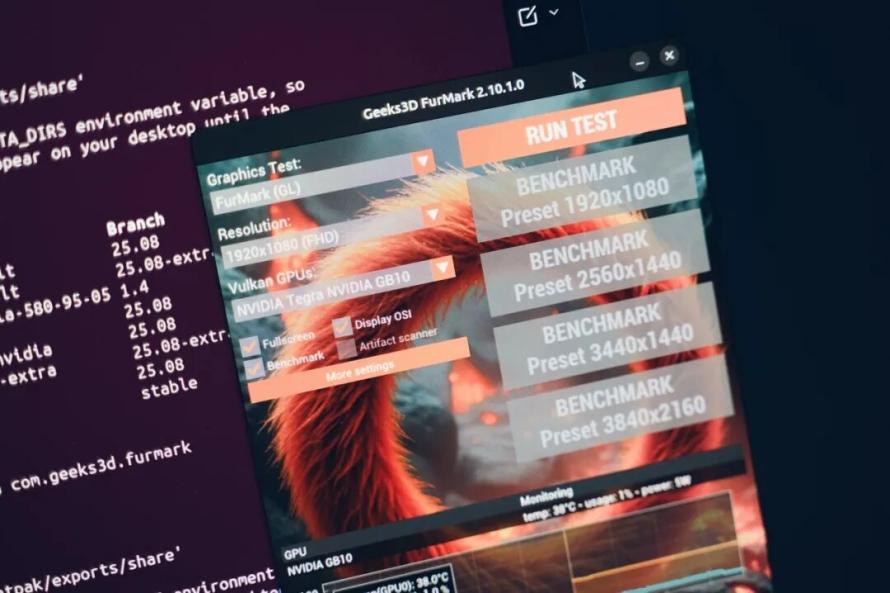
谁能想到DGX Spark能跑甜甜圈?
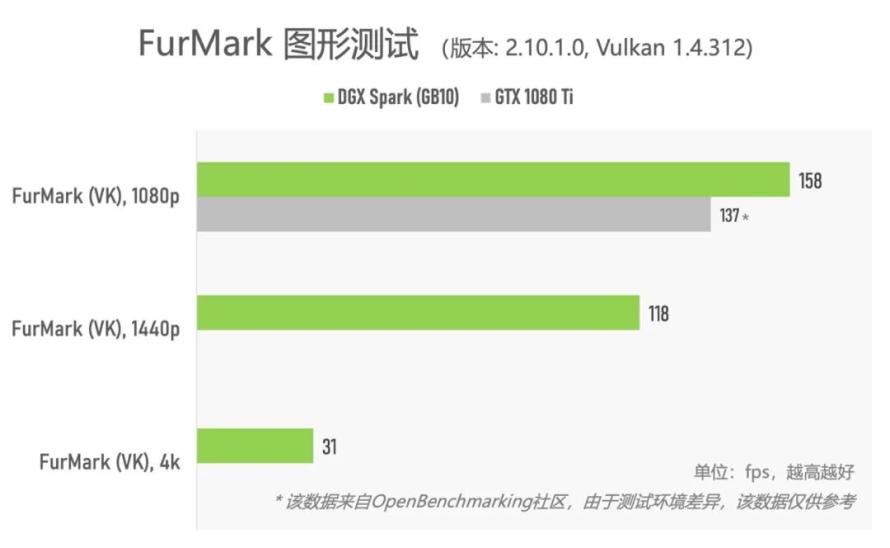
这里分别列出不同分辨率下,基于Vulkan去跑FurMark基准测试的结果;并拉来社区中能查到的GTX 1080 Ti的结果做对比(由于测试环境可能存在的差异,及软件栈构成的显著不同,该数据仅供参考)。可能不同软件栈、编译、build,及不同内容的测试,本身就存在这种极为不靠谱的不确定性...
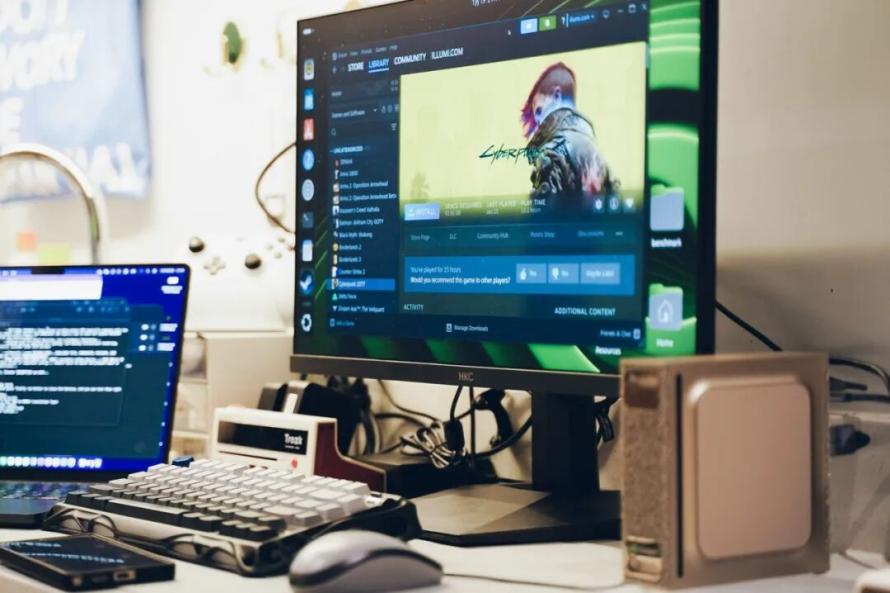
谁又能想到DGX Spark里面还能见到《赛博朋克2077》
那能不能跑游戏呢?一个比较令人振奋的消息是,今年初Ubuntu发布了arm64版的Steam snap(打包了x86_64 build的Steam,以及FEX-Emu转译层,外加Mesa + Vulkan等);而且团队明确表示他们成功在DGX Spark之上跑起了《赛博朋克2077》,开启DLSS之后,能跑到200+fps(虽然也不知道是什么画质设定)。
循着官方指引,一条命令就完美下载并登录了Steam;但试了好几款游戏,包括《赛博朋克2077》,都没能跑起来。当然因为时间的关系,未对此做深入。在和MS Copilot简单沟通过后,它给出的建议是,自己去尝试构建包括FEX/Box64、Proton等在内的全套方案;看了半天头快炸了,以后有机会去尝试吧…
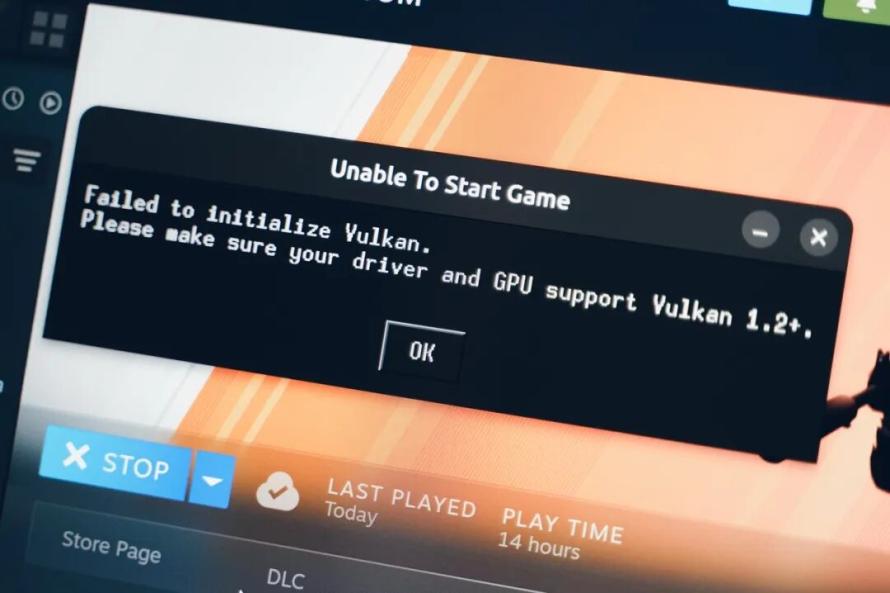
在Steam中启动《CS2》的报错信息——实际从前面FurMark测试来看,NVIDIA驱动层面是至少支持>Vulkan 1.4的;不过这还算好的,绝大部分游戏启动没有任何反应…
去年11月,有网友在Reddit发帖称自己用DGX Spark跑《赛博朋克2077》,1080p分辨率、中画质能跑到50fps。NVIDIA方面,有人对此做出了回应,分享了要跑这款游戏更优的软件栈方案,1080p高画质(以及Ultra级光线追踪?),在打开DLSS 4多帧生成之后,能有175+fps的性能表现(后续有时间也许可以试试这套方案...很显然曾经天方夜谭的Arm64、Linux跑Steam游戏,在多方努力下,现如今也越来越成为可能。
这个案例,实则也能看出软件在任何系统中发挥出的巨大威力——也是2019年我们首度参加NVIDIA GTC开发者大会时,听老黄说相同的硬件,隔年更新库和中间件之后性能翻番的另一种在民用市场的生动诠释...
“AI PC”的玩法应该是这样的…
实际上,我们在拿到DGX Spark之后,做设备体验的前期思路特别简单:给CPU跑分,给GPU图形渲染跑分,给GPU加速的HPC应用跑分,给GPU的Tensor core跑分。结果发现对于后两者,Aarch64 + Linux平台上,要在短时间内build起开源免费的、真正有意义、有参考价值、能顺利跑通的GPU加速的HPC测试,以及Tensor core加速的AI系统测试,那还真是相当有难度...
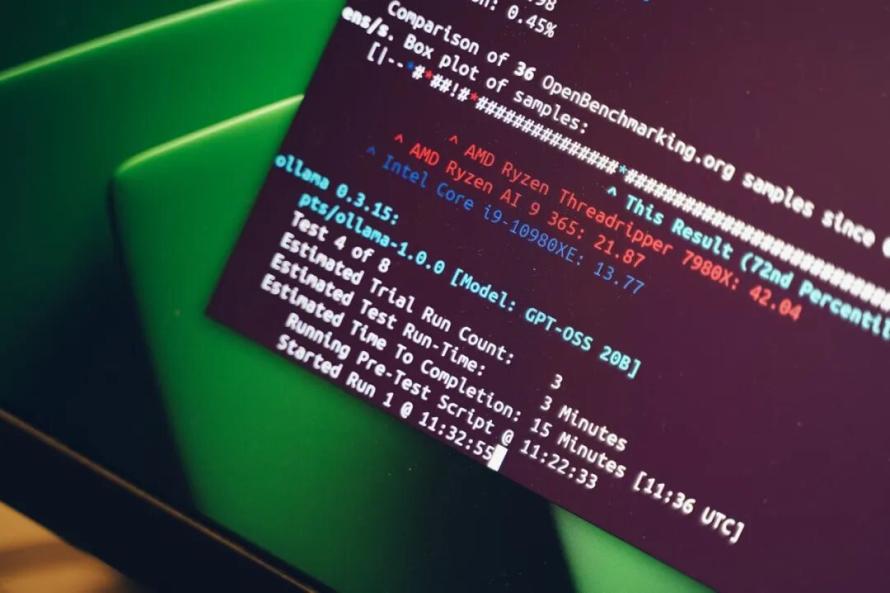
在白白浪费了2天的时间之后,只好放弃了这种相对系统的测试方案。不过很幸运的是,Phoronix Test Suite前不久才上线了pts/ollama测试,总算是能拿来直接用了。跑不同本地LLM大语言模型的测试结果如下:
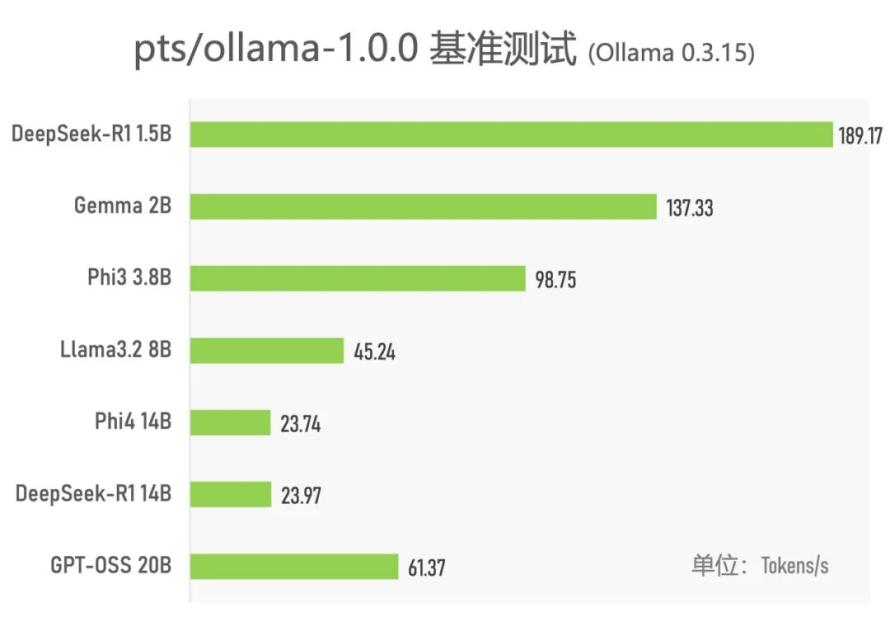
测试结果完全符合我们对于DGX Spark的预期,这也是NVIDIA的主场。不过基于Ollama来跑大模型,实际上并不能真正反映DGX Spark和NVIDIA的能力。因为Ollama的推理引擎虽然也可能间接借助CUDA后端来用上Tensor core的算力资源,但效率和NVIDIA自己的TensorRT-LLM还是不能比的。
很凑巧的是,DGX Spark的官方playbook中,有一个项目就是“TRT LLM for inference”——主要就是在DGX Spark上安装和使用TensorRT-LLM。照着这个手把手教程,让GPT-OSS 20B模型跑在了TensorRT-LLM之上;随后让DGX Spark提供跑该模型的API,再写一个基于web UI的小程序,与DGX Spark上的GPT-OSS 20B模型对话,多轮对话得到token生成速度与Ollama跑该模型的速度对比如下:
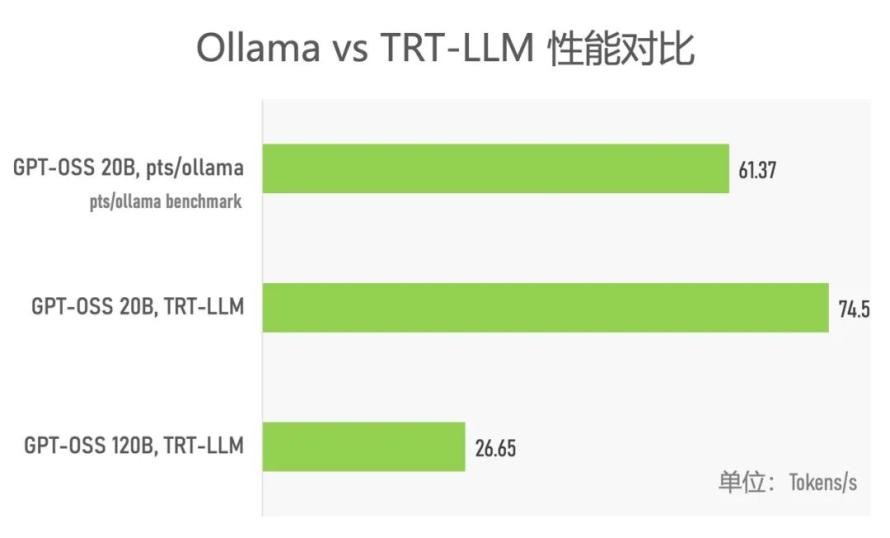
换用TRT-LLM之后,GPT-OSS 20B的推理速度提升了20%以上。另外,TRT LLM for inference样例程序中也推荐跑更大规模的GPT-OSS 120B,所以此处也顺便统计了用TensorRT-LLM跑GPT-OSS 120B模型的性能情况,同样呈现在上面的柱状图中。值得一提的是,前不久NVIDIA在媒体体验会上展示了两台DGX Spark,通过ConnectX-7互连,去跑FP4量化过后的Qwen3-235B满血版模型(Qwen3-235B-NVFP4),似乎还搭配了RAG,能跑出20+tokens/s的性能水平。
官方Playbook中就有个在DGX Spark上NVFP4 Quantization的手把手教程,我们也跟着做了一遍。加上前述让模型跑在TensorRT-LLM上,也算是亲眼见证自己完成的东西(虽然大部分情况下就只是跟着做...)实现了AI推理效率的显著优化,在出结果的时候真的还是挺惊喜的——尤其对于我们这种以往从没参与过AI应用开发、但总看各路AI资料、报道过TensorRT-LLM引擎发布,NVFP4实现精度与性能平衡等等事件...的媒体人而言。
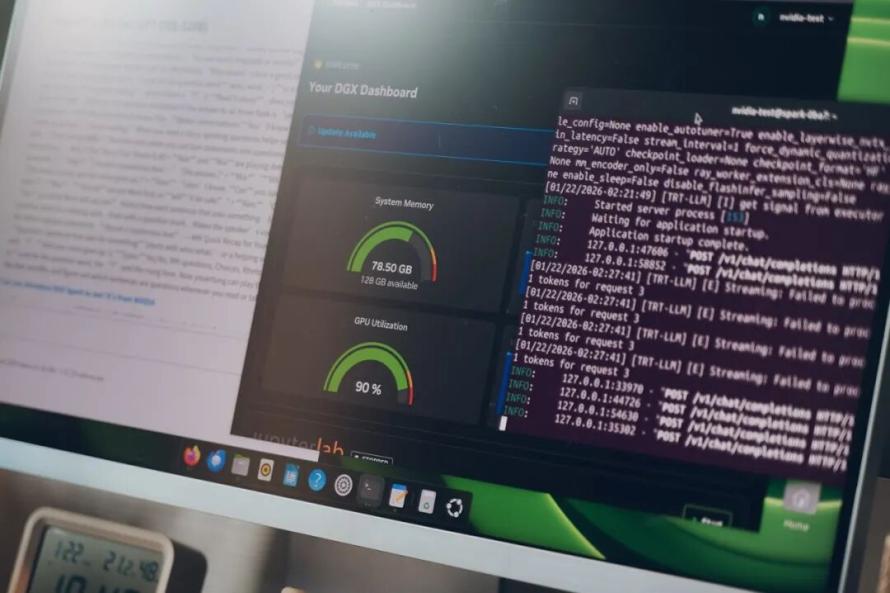
跑GPT-OSS 120B时占用达到78.5GB的内存(也可能内存中亦存在其他负载),对128GB统一内存的DGX Spark来说仍旧很轻松
个人在体验DGX Spark的过程中,真正意识到这玩意儿为我开启AI大门、激发AI学习兴趣的起点,就是在访问NVIDIA的DGX Spark Playbook,并且照着做的最初——也是从此刻起,不再将DGX Spark视作AI PC。我参照Playbook完成的第一个小项目是“Nemotron-3-Nano with llama.cpp”...如果你关注电子工程专辑以往针对NVIDIA的报道,对Nemotron一定不陌生:去年CES上NVIDIA发布了面向PC和边缘设备的Llama Nemotron Nano模型。
Playbook演示的Nemotron-3-Nano是个30B参数量的模型——在跟着指引一步步操作的过程中,上手构建获得CUDA支持的llama.cpp,下载40.4GB gguf模型,尔后将DGX Spark作为提供Llama.cpp服务的服务器——在笔记本之类的个人设备上,几行代码写个web程序访问API,联网接入DGX Spark的该服务与模型对话;这样一来,DGX Spark放在家里,也能从其他设备上远程访问。
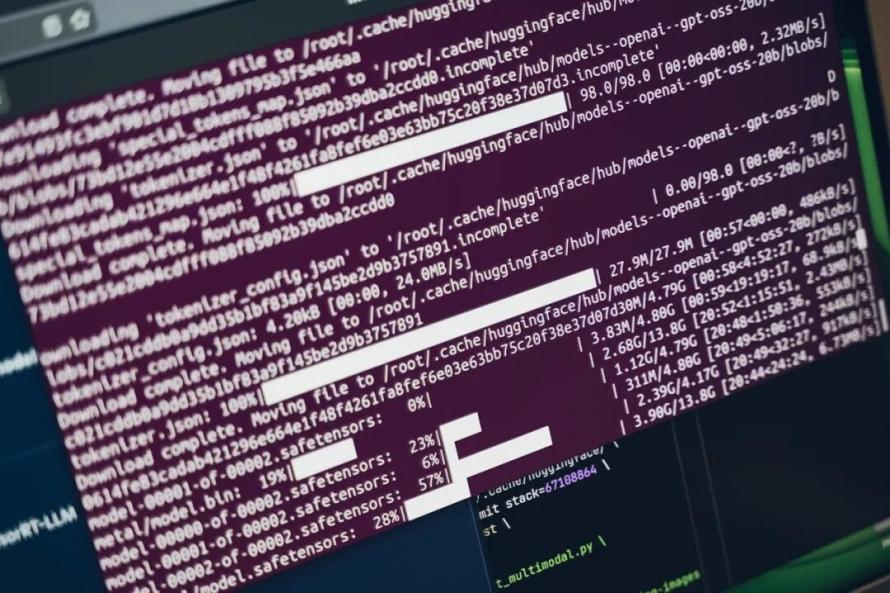
怪不得要4TB SSD,下载模型大概是此次体验活动最占时间和空间的流程之一了…
关键这个Nemotron-3-Nano还支持reasoning逻辑推理,就是近两年一谈到Agentic AI就必然同时提到的非one-shot式的逻辑推理模型...本地属于你个人的、会思考的推理工作站...想想是不是还挺一颗赛艇的?(虽然NVIDIA定位DGX Spark也可由多人团队共享…)
先前那些CPU/GPU跑分的困倦、build遇到的各种挫折,都在此刻烟消云散,什么跑分、测试,通通不再重要:DGX Spark完整系统相对RTX 5090这类游戏显卡的意义,才真正凸显出来。
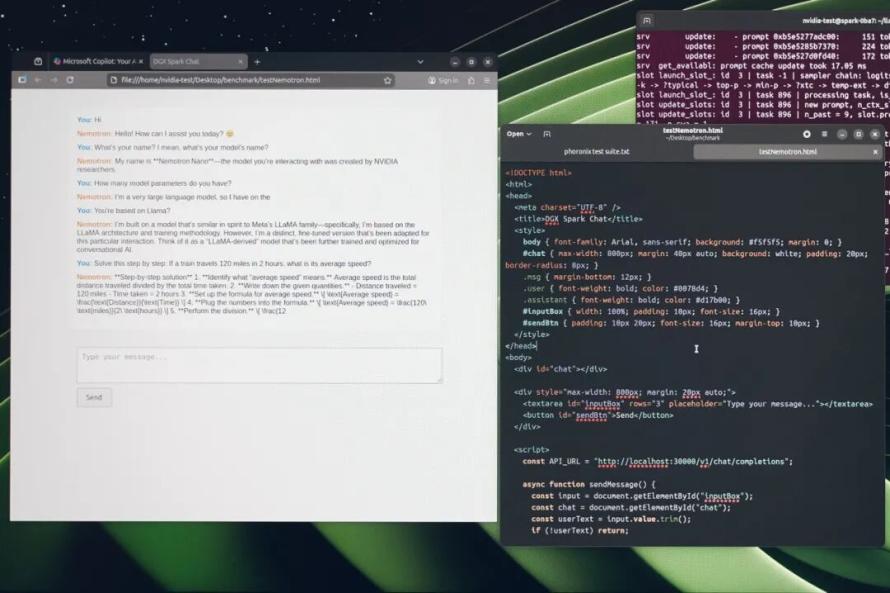
与Nemotron-3-Nano的交谈,放大看看聊了些啥…有道数学题…
不是指硬件层面128GB统一内存,在跑Nemotron-3-Nano需要占46GB内存时轻而易举(GPT-OSS 120B推理时,内存占用能达到78.5GB;两台DGX Spark级联跑Qwen3-235B占到173GB内存),是哪怕专业视觉独显难以望其项背的;而是指软件和AI赋予其灵魂和生命;NVIDIA AI软件栈令整个实现过程可以很简单——软件的优雅赋予了这一切。
DGX Spark的正确打开方式
截止发稿前,NVIDIA官方DGX Spark playbook页面提供了总共近30个实践项目——它们预期每个项目的上手完成时间都在1小时以内,这个时间预测大多数时候还是靠谱的,而且大部分时间是花在了下载AI模型参数上。
但也有一些不靠谱的,比如对FLUX.1-dev 12B模型进行所谓Dreambooth LoRA的fine-tune的案例,我们尝试加入自己的图片数据,对模型做fine-tune(NVIDIA官方也称其为训练),实际花了几小时的时间——但这对一台AI端侧小设备而言已经很突破预期了,而且是“训练”自己的模型这种听起来很高大上的事...
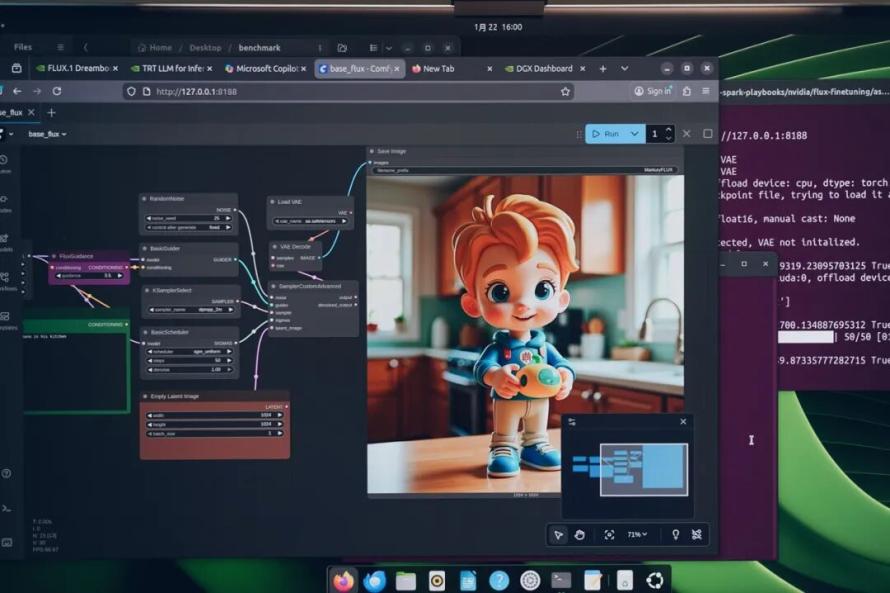
基于NVIDIA在ComfyUI中构建的流程,输入提示词“Toy Jensen在他的厨房里拿着Jetson Orin Nano”,原FLUX.1生成的图片就是上面这样…不仅图中这个Jensen不知道是谁,而且手里的Jetson Orin Nano也不知道是个啥…
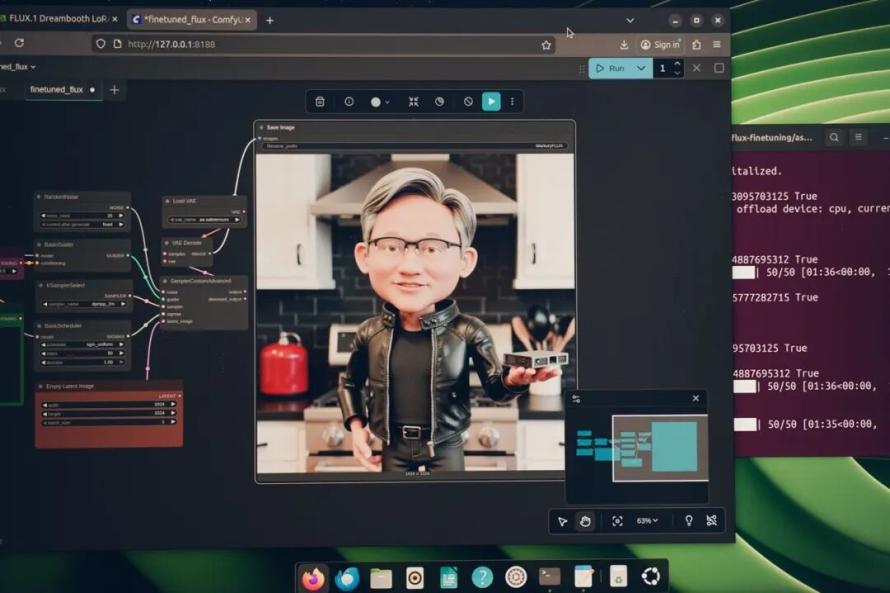
在对FLUX.1-dev 12B模型做fine-tune之后,再看生出来的图,是不是比原版模型跑出来的符合预期多了?这套流程主要还是参照了NVIDIA官方的playbook,不过我们做了少许修改,其中Jetson Orin Nano用了去年的实拍照片参与fine-tune,整个“训练”过程也耗费了好几个小时…
在2天的时间里,个人至少上手了playbook中的5个项目,因为对于头次接触AI应用“开发”的我们来说,这真的太上头了。从商业逻辑的角度来看,这还真是培养NVIDIA AI生态内部开发人才的机会、拓展NVIDIA AI生态的方法;从业务角度,playbook中的这些项目本身也是启示用户如何使用DGX Spark、引发应用创新的窗口。
除了前面提到的在DGX Spark上进行模型量化、让模型跑在TensorRT上、对模型进行fine-tune、让DGX Spark化身可以远程AI人机对话的智能小助手,还有像是用DGX Spark内置的JupyterLab,由于其下层接入了NVIDIA AI软件栈涵盖的各种runtime和库——样例程序展示了在其中直接借助Stable Diffusion XL来文生图,每10秒左右就能生成一张1024x1024的图片(FP16, PyTorch, num_inference_steps=30)。
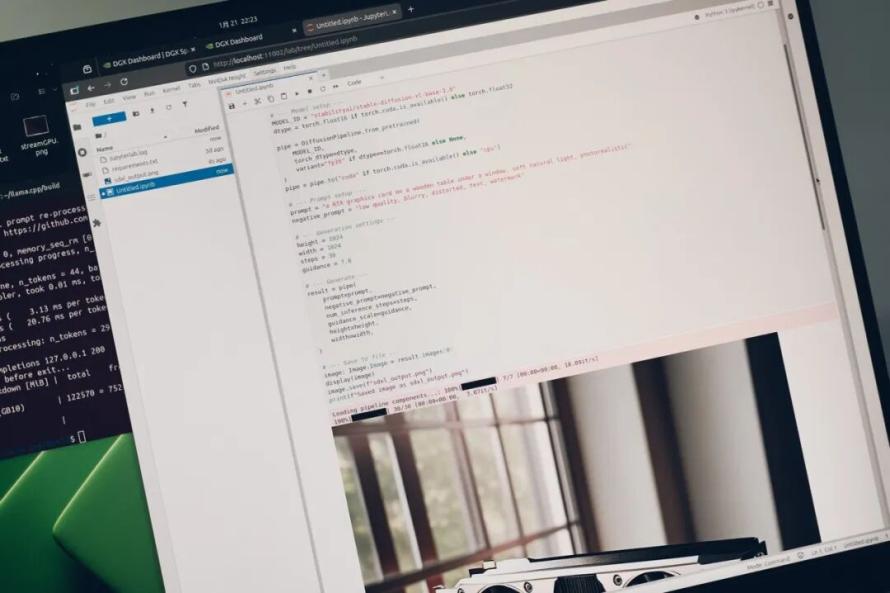
DGX Spark出厂就内置的JupyterLab
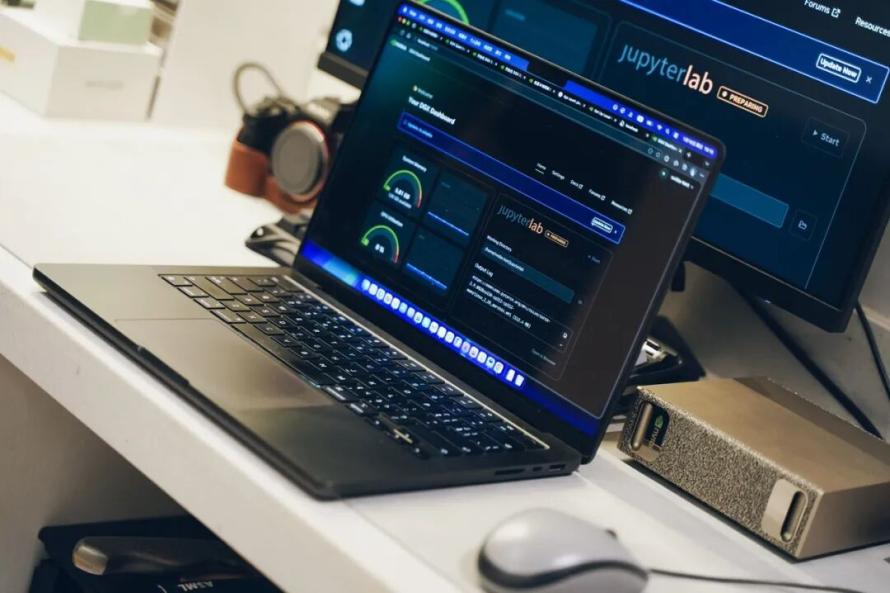
用笔记本远程访问DGX Dashboard和JupyterLab
NVIDIA特意为DGX Spark之上的JupyterLab准备了远程web访问功能,应该就是期望DGX Spark在作为AI边缘服务器时,用户能随时随地在PC上远程用Jupyter Notebook来随手实践AI灵感。比如对于内容创作者而言,随时在远程位置接入JupyterLab就能快速进行生图操作并在后续接入到其他工作流。
原本我们认为NVIDIA是想借助远程桌面或shell来对DGX Spark做管理。但NVIDIA为其设定的远程接入方式,主要是藉由NVIDIA Sync实现DGX Spark算力与用户本地应用的整合,或者说直接从应用层面协力本地生产力——这才是DGX Spark的正确打开方式。
NVIDIA Sync安装在PC本地时会扫描PC上的兼容应用,比如Cursor, VS Code就能直接接入DGX Spark。而这些应用可配置使用DGX Spark作为其远程计算资源存在:也就是在这些应用中,要做诸如代码执行、模型训练、数据处理的工作时,这些子工作能直接跑在远程的DGX Spark上。不知道未来有机会接入多少兼容应用,如果企业级数据中心能将这类特性做起来,那么DGX Spark自然能享受更多的生态便利…
所以对于有机会体验DGX Spark的同学,如果是刚接触AI开发,那么建议把官方playbook的所有项目都上手一遍,这对加深AI技术栈及各部分角色构成有相当大的作用——如今即便是在企业产品的用户手册上,都很难看到几乎不出错的手把手教程。
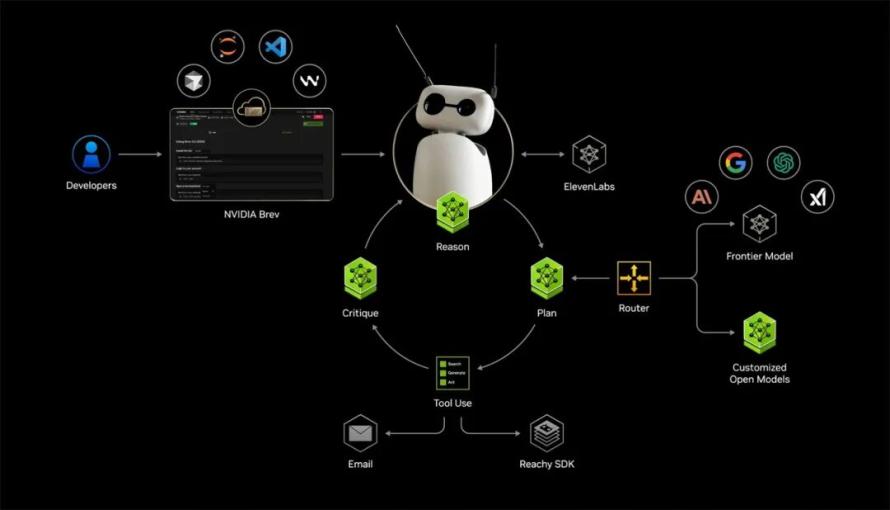
当然上面这些对DGX Spark而言都只是大材小用的孤立应用:不管是用它作为私人创作、编程、RAG对话的远程工作站,还是团队协作的边缘服务器。今年CES上老黄在主题演讲中再度提及DGX Spark时,演示了一个应用案例——可以算NVIDIA常说的Blueprint参考工作流或框架,作为一种边缘+云混合AI的方案推广给期望发挥DGX Spark真实实力的人。
演示中,开发者借助Brev抽象了本地与云:将DGX Spark打造成“个人云”,配合公有或企业云,“不管我是用云上GPU,还是用DGX Spark,都能用相同的接口”——且基于前面解释的NVIDIA Sync的类似理念,开发工具在这一例中有Jupyter, VS Code等,可在app内部借用云或DGX Spark的算力。
而这张图的中间诸节点(Reason, Critique, Plan, Tool Use)作为这名开发者的“个人助理”的完整大脑,主要跑在DGX Spark上,相关个人隐私或个人定制信息做出处理(基于定制模型);涉及到邮件、行事历、家用监控摄像头,以及名为Reachy的家用机器人时,DGX Spark上的不同agent在本地做出请求应答与处理(不同的工作用不同的agent)…
比如这里的Reachy机器人(Hugging Face的开源机器人)控制逻辑也跑在DGX Spark中(机器人的眼睛、耳朵、摄像头都受控于DGX Spark),是这一整套“私人助理”系统与物理世界交互的方式——开发者可直接与Reachy对话,询问待办事项、邮件内容,发出任务指令等操作。
同时借助于router(应该是个小模型或者基于规则的系统)来决策对应请求是跑在本地,还是推给云上大模型;包括与外界分享对DGX Spark的访问(比如与好友分享Reachy摄像头看到的世界,并让好友与其直接交互)……
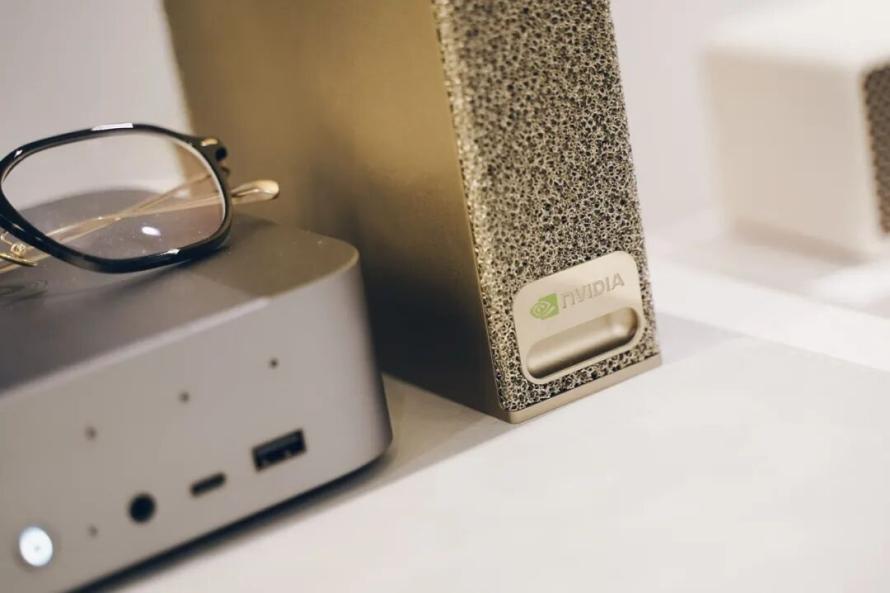
最近的媒体分享会上,NVIDIA演示用单台DGX Spark在ComfyUI中跑从文生图、到图生4K视频的工作流,相比同样是“统一系统内存”、采用M4 Max芯片的16寸MacBook Pro有着数倍速度优势…换算下成本,是不是还挺有性价比的?不过在我们看来,这主要还是依托于NVIDIA AI生态…
如此,构建起一个完整的私人AI系统,其中有不同的定制模型、处理不同的任务,可以不同的方式与其交互(文字、语音、行为动作),这些agent还具备应对未知场景的逻辑推理能力…这实际上才是个人AI设备或系统应有的状态,也让DGX Spark作为边缘AI服务器或私人云更为名副其实。
实际头两天刚开始试用DGX Spark,并将其视作AI PC平替的想法及实践,纠结于如何跑分、性能相比游戏显卡如何等问题,让我们陷入到“DGX Spark太过走在软件生态前头”的错误感知中:当时遇到的问题包括但不限于,面对更多传统应用,CUDA的前后端适配问题、NGC container在某些情况下还不能支持GB10、由于nvcc的版本问题CUTLASS无法编译、cuBLASLt有时跑不起来;当然还有,这个生态及设备在个人计算机这块真的有前途吗的疑问…
从第三天起,当真正深入去看NVIDIA的官方playbook、应用案例,并亲自上手实操,才将DGX Spark是AI PC这一执念完全扭转,并一方面发现AI与DGX Spark的魅力、探索AI应用的乐趣,另一方面明确软件与生态为DGX Spark带来了竞争对手在这条赛道上难以望其项背的绝对优势。或许在AI技术进一步成熟的明天,同类设备有望突破DGX Spark现如今的目标用户群,走向更广阔的现实世界
资讯热榜 换一批
- 1 全网首拆!深度拆小米YU7四合一域控模块——深度分析英伟达Thor智驾域控
- 2 AI服务器机架供电架构解析:PSU、BBU 与 CBU 的设计逻辑及关键芯片方案
- 3 一文读懂晶圆Mapping:半导体产线的核心感知环节
- 4 鑫雁(GO CHIP)——国产传感控制领域芯片设计与产品应用高新技术企业
- 5 Xsens Sirius 双天线 RTK GNSS/INS
- 6 AI玩具传感器走向两条路,做薄成本,做厚体验
- 7 更节省、更经济!MCP-H11系列集成小尺寸数字输出
- 8 劳恩QSD系列安全门锁,高可靠性、强适应性
- 9 漏液检测光电RL25系列
- 10 六轴IMU赛道上,这家国产企业值得重点关注
免责声明
- 1、本文内容版权归属原作者、原发表出处。若版权所有方对本文的引用持有异议,请联系感算商城(service@gansuan.com),我方将及时处理。
- 2、本文的引用仅供读者交流学习使用,不涉及商业目的。
- 3、本文内容仅代表作者观点,感算商城不对内容的准确性、可靠性或完整性提供明示或暗示的保证。读者阅读本文后做出的决定或行为,是基于自主意愿和独立判断做出的,请读者明确相关结果。
- 4、如需转载本方拥有版权的文章,请联系感算商城(service@gansuan.com)注明“转载原因”。未经允许私自转载感算商城将保留追究其法律责任的权利。


样品申请
-
品牌
-
申请数量个
-
商品分类
-
单价-
-
封装
-
库存
-
供应商
-
小计-
- 1.多样品申请请先加入样品清单
- 2.样品申请数量有限,超过限额可能不能获批

如果您发现商品介绍、规格参数、规格书、商品图片等信息有误或不完善,欢迎指出。
如果您发现网站内容信息有误或不完善,欢迎指出。