

具身智能语音交互解决方案
来源:奥音贝科技
发布时间:2026-05-08
基于痛点研究,本系统面向具身智能复杂语音交互场景,采用麦克风阵列拾音模块、扬声器模块与声学算法一体化设计,实现声源定位、波束形成与语音增强处理。
系统可有效抑制侧向及多说话人干扰,提升目标语音信噪比与识别稳定性,适配嵌入式平台运行,具备良好的可扩展性与场景定制能力。
但在复杂嘈杂的环境中,语音识别的准确性仍存在诸多挑战,而造成这一问题的罪魁祸首则是嘈杂的背景噪声与复杂的语音来源,这使得语音识别的准确率和交互体验受到较大影响。
语音信号易受干扰:具身智能的使用环境复杂多样,常伴有环境噪声、干扰声源以及混响等,这些因素会使语音信号失真,导致语音识别困难。例如在家庭环境中,可能存在电视声、电器运行声等多种噪声;在工业场景中,机器的轰鸣声更是会对语音输入产生严重干扰。
远场语音交互难题:在远场语音交互场景下,具身智能与用户的距离较远,语音信号的强度会随着距离的增加而衰减,同时混响和背景噪声的影响也会更加显著,这使得远场语音识别的准确率大幅下降,限制了具身智能的使用范围和交互效果。
多说话人场景的挑战:当环境中存在多个说话人时,具身智能难以准确地识别出目标说话人的语音,容易出现语音信号混淆、识别错误等问题,无法满足多用户的交互需求。
现有降噪技术的局限:传统的降噪算法如谱减法、Wiener滤波等,在抑制噪声的同时往往会损失部分语音信号,导致语音失真,难以满足具身智能对语音质量的高要求。
基于痛点研究,本系统面向具身智能复杂语音交互场景,采用麦克风阵列拾音模块、扬声器模块与声学算法一体化设计,实现声源定位、波束形成与语音增强处理。
系统可有效抑制侧向及多说话人干扰,提升目标语音信噪比与识别稳定性,适配嵌入式平台运行,具备良好的可扩展性与场景定制能力。
相比通用拾音方案,本系统具备以下优势:
1. 场景定制能力
针对特定具身智能使用环境进行优化,而非通用模板化处理。
2. 强抗干扰能力
抑制侧向与后方语音干扰
提升目标语音识别稳定性
降低误触发概率
3. 端侧完整处理链路
声源定位 + 波束形成 + 增强一体化
适配主流处理平台
4. 可复用与可扩展性
可适配不同阵列尺寸
可迁移至不同嵌入式平台
支持根据不同终端产品定制参数,可灵活嵌入具身智能头部、智能家电、智能看板等智能设备当中。
1. 拾音模块
阵列形式: 4麦或6麦阵列,由多个高性能MEMS麦克风组成,负责语音信号拾取。
设计目标: 提供空间方向信息与多通道数据支撑
核心作用:
提供声源方向信息
支持实时声源定位(DOA)
为波束形成提供空间分辨能力
提升目标语音与干扰语音的可分离性
该阵列设计针对语音频段进行优化,兼顾结构尺寸与方向分辨能力,适配具身智能头部或上部结构集成。
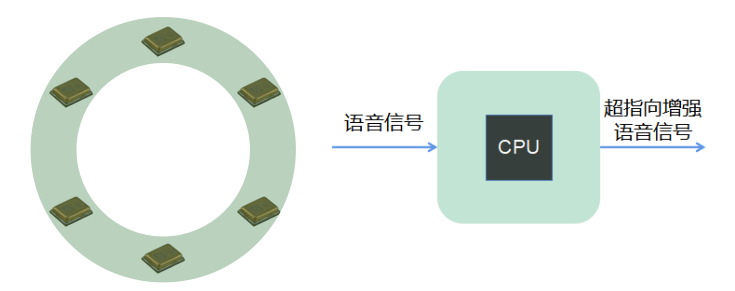
拾音与定位模块示意图
AI降噪模块:由高性能DSP与MCU组成,执行语音信号预处理、AI模型去噪、输出降噪后语音信号功能,内嵌轻量化降噪模型,运行速度快,功耗低。
2. 发声模块
本方案在设计阶段充分考虑具身智能自身扬声器对拾音系统的影响:
物理结构上进行隔离优化
算法层面配合回声抑制策略
支持全双工语音交互
确保具身智能在播报语音时,不影响用户语音采集质量。
3. 声学算法模块
本模块运行于 RK3576 / RK3588等核心板端侧,实现完整声学处理链路。
功能链路:
多通道音频输入 → 声源方向估计 → 目标方向跟踪 → 自适应波束形成 → 语音增强输出
3.1 声源方向估计
实时估计主要说话人方向
支持存在多个干扰声源的环境
为后续波束控制提供方向依据
利用环形麦克风阵列,利用TDOA算法,定位主交互目标声源方位,结合滤波算法,实时追踪交互目标声源方位,定向增强目标语音。
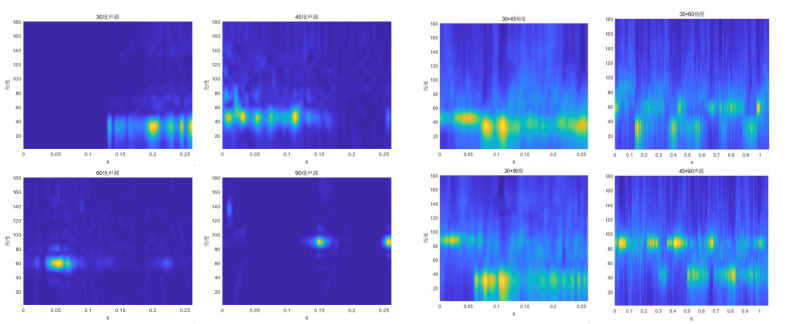
单人(左)双人(右)声源定位效果
3.2 自适应波束控制
根据目标方向动态调整波束指向
抑制非目标方向语音
提高目标语音信噪比
3.3 语音增强输出
结合VAD算法与RNN网络,对输入音频信号进行噪声压制及人声增强,依据人声输入强弱自动调节麦克风增益,灵活应对远近场语音交互。
提升目标语音清晰度
降低环境干扰对 ASR 的影响
为下游语音识别系统提供稳定输入
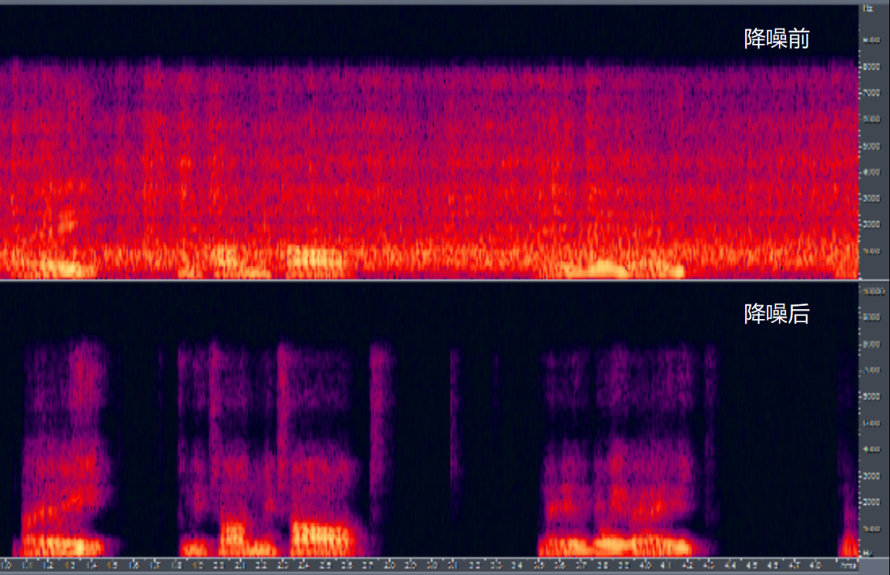
具身智能多用户交互
展厅 / 商业空间讲解
教育类具身智能交互
陪伴类具身智能交互
特殊声学环境交互
用户体验提升效益
交互流畅度增强:通过有效降噪,具身智能能够实时准确识别用户的语音指令,减少因语音识别错误导致的交互中断或误解,使具身智能与用户之间的交流更加顺畅自然,交互效率大幅提高,用户能更便捷地获取所需服务或信息,如在智能家居场景下,用户可快速指令具身智能控制家电,无需重复说话。
适用场景拓展:该系统使具身智能可以在各种嘈杂环境中正常使用语音交互功能,如在工厂、医院、商场等高噪声场所,具身智能可作为辅助工作人员或服务人员,与人类进行高效语音沟通,为用户提供更加广泛的服务,拓宽了具身智能的应用范围和使用价值。
系统性能优化效益
语音识别准确率提升:降噪系统精准去除环境噪声干扰,为语音识别模块提供更清晰纯净的语音信号,使得语音识别算法能够更准确地分析和理解语音内容,大幅提高识别准确率,减少了误触发和误识别的情况,增强了系统的可靠性和稳定性。
计算资源高效利用:高质量的降噪处理减少了语音信号中的冗余信息和噪声成分,使后续的语音识别和语义理解等处理过程更加高效,降低了对计算资源的消耗,提升了整个系统的运行效率,有助于实现更复杂的语音交互功能和更快速的响应。
安全与可靠性增强效益
关键指令准确执行:在一些对安全性要求较高的场景中,如工业生产、紧急救援等,具身智能能够准确接收和执行关键语音指令,避免因语音识别错误导致的潜在危险和事故,确保具身智能操作的安全性和可靠性。
系统稳定性提高:有效的降噪系统减少了语音输入中的不确定性因素,使整个语音交互系统更加稳定运行,降低了因语音问题引发的系统故障或异常,保障了具身智能在长期使用过程中的稳定性和可靠性。
商业价值提升效益
产品竞争力增强:具备高性能语音输入降噪功能的具身智能,能为用户提供更优质、更可靠的服务体验,相比同类产品具有明显的竞争优势,有助于提升产品在市场中的竞争力,吸引更多用户和客户,从而增加市场份额和销售量。
品牌价值提升:该系统体现了研发企业在语音交互技术领域的先进水平和创新能力,有助于树立企业在高科技领域的良好形象,提升品牌知名度和美誉度,为企业带来更多的商业机会和品牌价值增值。
免责声明
- 1、本文内容版权归属原作者、原发表出处。若版权所有方对本文的引用持有异议,请联系感算商城(service@gansuan.com),我方将及时处理。
- 2、本文的引用仅供读者交流学习使用,不涉及商业目的。
- 3、本文内容仅代表作者观点,感算商城不对内容的准确性、可靠性或完整性提供明示或暗示的保证。读者阅读本文后做出的决定或行为,是基于自主意愿和独立判断做出的,请读者明确相关结果。
- 4、如需转载本方拥有版权的文章,请联系感算商城(service@gansuan.com)注明“转载原因”。未经允许私自转载感算商城将保留追究其法律责任的权利。


样品申请
-
品牌
-
申请数量个
-
商品分类
-
单价-
-
封装
-
库存
-
供应商
-
小计-
- 1.多样品申请请先加入样品清单
- 2.样品申请数量有限,超过限额可能不能获批

如果您发现商品介绍、规格参数、规格书、商品图片等信息有误或不完善,欢迎指出。
如果您发现网站内容信息有误或不完善,欢迎指出。